Hammer's个人博客

分享影像见闻、编程和生活的点滴

关于我

Hammer

Hammer

一个影像产品经理,也是独立开发者,分享影像见闻和产品开发

影像技术 Python Swift 我的产品

最新文章

解决deepseek-v4-flash-0731版本在ccswitch无法显示max档位的问题
2026年08月04日 代码交流

解决deepseek-v4-flash-0731版本在ccswitch无法显示max档位的问题

1. 问题 随着 deepseek-v4-flash-0731 版本发布,现在新版的的v4-flash支持low、high、max三档思考模式,但是在 CC Switch 的 DeepSeek-response 配置里,思考强度明明设成了 max,Codex 对话里却有两个怪现象: 选择器只有"轻度 / 高"两档,找不到 max; 抓包一看,实际请求走的也是 high,根本没跑 max。 配置文件看起来又没问题(config.toml 里写的确实是 max),就是死活不生效。 2. 分析原因 问题不在 CC Switch,也不在模型目录,而是 Codex Desktop 自己的两层机制: 实际强度没走 max:Codex 每个对话(线程)有自己的思考强度设置,存在应用状态库里。这个线程级设置会覆盖 config.toml 里的默认值。当时线程被设成了 high,所以请求只按 high 发。 选择器看不到 max:Desktop 选择器显示的档位 = 模型支持的档位 ∩ 应用启用的档位。deepseek-v4-flash 支持 low / high / max,但应用启用档位列表默认是 low / medium / high / xhigh / ultra,默认不含 max。一交集,就只剩 low / high,max 被藏起来了。 一句话:是 Desktop 的 UI 过滤把 max 挡住了,加上线程级设置覆盖了 config 默认值。 3. 如何解决 改三处,再重启一次: 在 ~/.codex/config.toml 的 [desktop] 段加一行,把 max 放回启用档位列表; 把同一行同步进 CC Switch 数据库里 DeepSeek-response 的配置模板,防止切换 provider 时被覆盖; 把当前对话在状态库里的 reasoning_effort 从 high 改成 max。 最后完全退出 Codex Desktop(Cmd+Q)再重新打开。重启后选择器就出现"最高"档,抓包确认请求体里 reasoning.effort = max,修复完成。 4. 解决细节提示词(AI 可直接执行) 把下面的内容整段交给一个能读写本地文件的 AI 执行即可。 任务 修复 Codex Desktop + CC Switch 使用 deepseek-v4-flash 时,对话选择器无法显示/使用 max 思考强度的问题。验收标准:重启后当前对话选择器能看到"最高(max)"档,且实际请求以 reasoning.effort = max 发出。 根因(已定位,按此修改即可) Desktop 选择器档位 = 模型 supported_reasoning_levels ∩ 应用设置 enabled-reasoning-efforts。该设置默认 ["low","medium","high","xhigh","ultra"],不含 max。 该设置从 ~/.codex/config.toml 的 [desktop] 段读取(不是 [features] 段)。 对话实际强度由 ~/.codex/state_5.sqlite 的 threads.reasoning_effort 决定,会覆盖 config.toml 的 model_reasoning_effort 默认值。 修改步骤 0. 备份(必做,出错可恢复) 12345TS=$(date +%Y%m%d_%H%M%S)mkdir -p ~/.cc-switch/backupscp ~/.codex/config.toml ~/.cc-switch/backups/config.toml.before-maxfix-$TScp ~/.cc-switch/cc-switch.db ~/.cc-switch/backups/cc-switch.db.before-maxfix-$TSsqlite3 ~/.codex/state_5.sqlite ".backup '$HOME/.cc-switch/backups/state_5.sqlite.before-maxfix-$TS'" 1. 修改 ~/.codex/config.toml 在 [desktop] 段(即含 followUpQueueMode 的那段)追加一行,kebab 键必须加引号: 123[desktop]followUpQueueMode = "queue""enabled-reasoning-efforts" = ["low", "medium", "high", "xhigh", "max", "ultra"] 注意:放在 [desktop] 下,不要放 [features]。 2. 修改 CC Switch 数据库(DeepSeek-response 模板) 目标:~/.cc-switch/cc-switch.db 中 providers 表、app_type='codex' AND name='DeepSeek-response' 行的 settings_config JSON 里,$.config 这个字符串中的 [desktop] 段加上同一行。 务必用 Python 的 json 模块读写(JSON 字符串内引号需转义,用 shell 直接拼裸引号会写坏 JSON): 1234567891011121314import sqlite3, jsondb = sqlite3.connect('/Users/<用户名>/.cc-switch/cc-switch.db')row = db.execute("SELECT settings_config FROM providers WHERE app_type='codex' AND name='DeepSeek-response'").fetchone()[0]cfg = json.loads(row)conf = cfg['config']old = '[desktop]\nfollowUpQueueMode = "queue"'new = old + '\n"enabled-reasoning-efforts" = ["low", "medium", "high", "xhigh", "max", "ultra"]'assert old in confcfg['config'] = conf.replace(old, new, 1)db.execute("UPDATE providers SET settings_config=? WHERE app_type='codex' AND name='DeepSeek-response'", (json.dumps(cfg, ensure_ascii=False),))db.commit()# 校验:必须输出 json_valid=1print(db.execute("SELECT json_valid(settings_config) FROM providers WHERE app_type='codex' AND name='DeepSeek-response'").fetchone()) 3. 修改当前线程的思考强度 先查线程 ID(正在对话的线程): 1sqlite3 ~/.codex/state_5.sqlite "SELECT id, model, reasoning_effort FROM threads ORDER BY updated_at DESC LIMIT 10;" 然后把对应线程改为 max: 1sqlite3 ~/.codex/state_5.sqlite "UPDATE threads SET reasoning_effort='max' WHERE id='<线程ID>';" 4. 重启应用 提示用户完全退出 Codex Desktop(Cmd+Q,不是关窗口,关窗口会最小化到托盘),再重新打开。 验证 重启并让用户发一句话后检查: 12345678910# 1) 线程状态sqlite3 ~/.codex/state_5.sqlite "SELECT id, model, reasoning_effort FROM threads WHERE id='<线程ID>';"# 期望 reasoning_effort = max# 2) 实际请求体(Codex 自身 HTTP 客户端日志,等价于抓包)sqlite3 ~/.codex/logs_2.sqlite "SELECT feedback_log_body FROM logs WHERE thread_id='<线程ID>' AND feedback_log_body LIKE '%POST to https://api.deepseek.com/responses%' ORDER BY ts DESC LIMIT 1;"# 期望包含 "reasoning":{"effort":"max","summary":"detailed"}# 3) 会话记录# ~/.codex/sessions/<日期>/rollout-<线程ID>.jsonl 的 turn_context 应显示 effort:"max" 注意事项 不要修改任何 API key、token、认证字段。 修改 cc-switch.db 后必须确认 json_valid(settings_config) = 1。 修改前先备份,出错从备份恢复。 不要擅自向用户线程发送测试消息来触发验证轮次,除非用户明确要求。

阅读更多 →
LLM Wiki for Intel Mac:把零散文档编译成会生长的个人知识库
2026年07月30日 代码交流

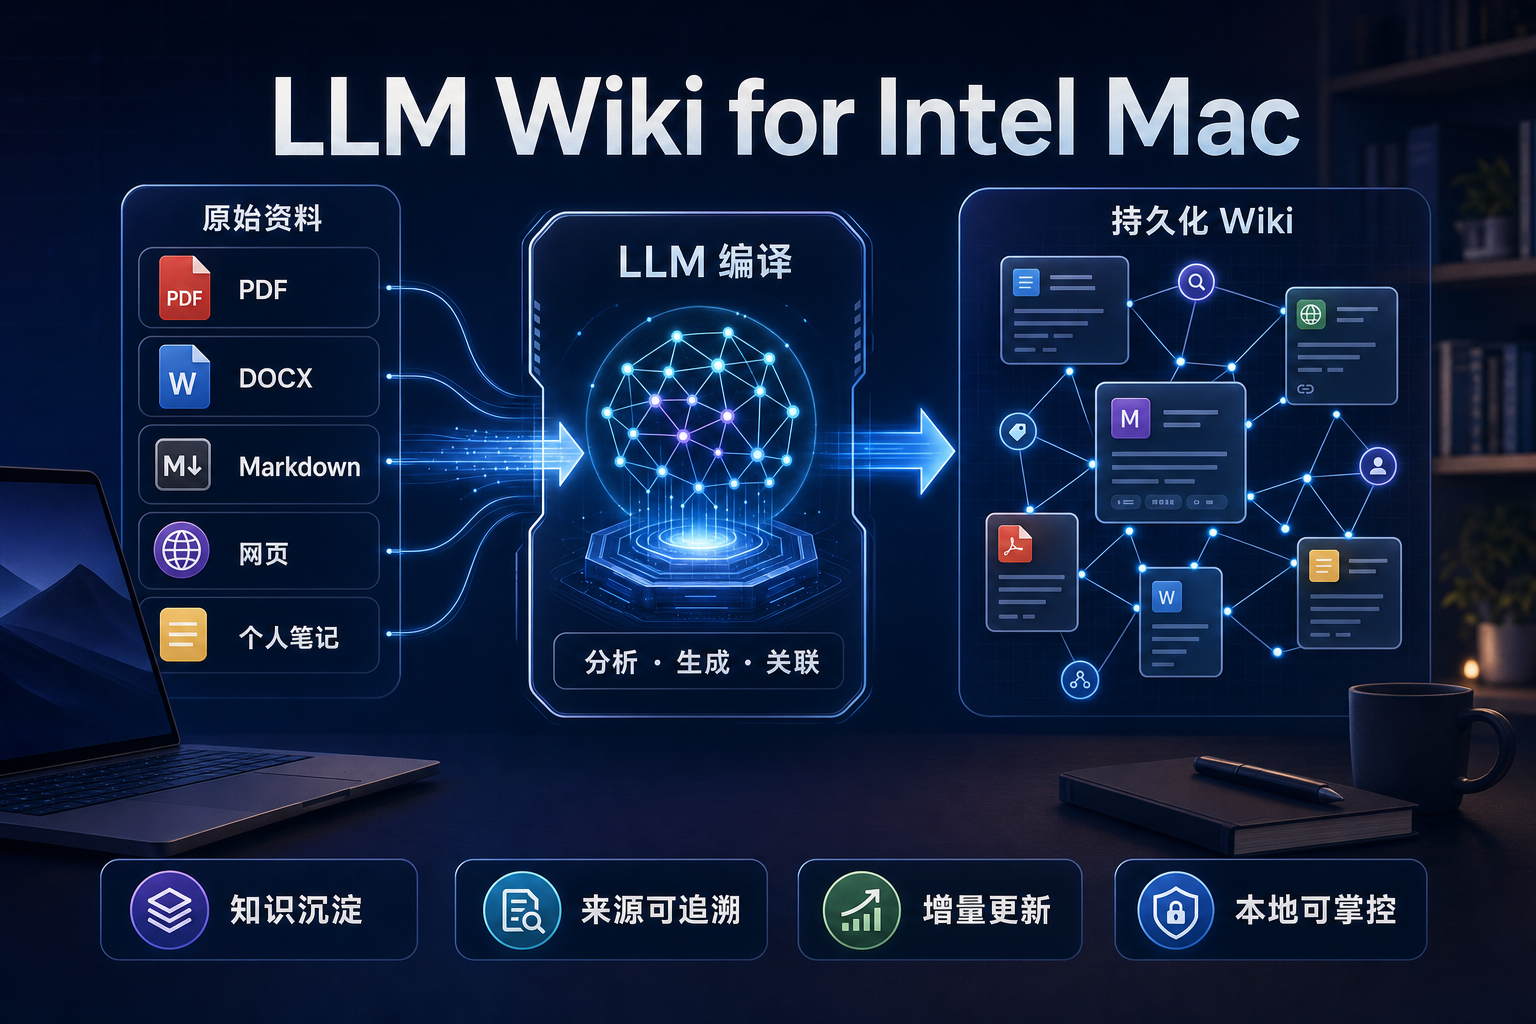
LLM Wiki for Intel Mac:把零散文档编译成会生长的个人知识库

简介 LLM Wiki 源于 Andrej Karpathy 提出的个人知识库模式。不同于每次提问都临时检索资料的传统 RAG,它会让大语言模型先分析文档,再生成带来源和交叉链接的 Markdown 页面,把 PDF、Office 文档、笔记与网页逐步“编译”为可持续更新的 Wiki。 它的优势是知识能够长期沉淀、来源可以追溯,并能通过知识图谱发现不同资料之间的联系;生成目录还可用 Obsidian 打开。系统支持增量处理,未修改的文件无需重复生成,也可分别配置 Chat、Ingest 和 Embedding 模型。 Intel Mac 版本 我基于 LLM Wiki 0.6.6 构建了适用于 Intel x64 Mac 的版本: 项目地址: Kinghammer1/LLM-Wiki-for-x64-Intel-Mac 安装时从项目主页进入 Releases,完成安装后新建 Wiki 项目,配置可生成文本的 Ingest 模型,再从 Sources 导入资料即可。bge-m3 属于可选的 Embedding 模型,用于语义检索,不负责生成 Wiki。首次建议先导入少量文件测试,确认活动面板开始处理并生成页面后,再批量导入。

阅读更多 →
GPT5.4将会改变整个影像行业
2026年03月21日 影像技术

GPT5.4将会改变整个影像行业

GPT5.4将会改变整个影像行业! GPT5.4的图像理解能力已经到了非常变态的水平,基本上拥有了影像行业中级甚至高级的测评,图像测试,效果测试,美学效果评测工程师的水平了。这意味着什么?过去影像行业依赖以人为美学评价基础的模式将会被颠覆,虽然最近几年的大模型发展非常迅猛,即使类似Gemini有着很强的多模态理解能力和图像能力,但是在真正的美学评价和对图像细节内容和美感,图像质量的主观评价上,大模型的能力还是不足以和人类媲美的。 但是今天,GPT5.4将会改变这一切。随便放几张测试图吧。 不多解释了,即使只是把GPT5.4当作任何模型训练和图像优化调校的损失函数,那也足以让模型直接起飞。 改变,从现在开始。 2026-03-21

阅读更多 →
我的第一款上架APP:照片保存助手
2026年03月19日 我的产品

我的第一款上架APP:照片保存助手

照片保存助手是一款给 iPhone 和 iPad 用户准备的照片整理工具。 如果你的照片和视频散落在“文件”App、网盘下载目录、相机导出的文件夹,或者 U 盘拷贝出来的资料里,它可以帮你更省心地整理回系统相册。 前往 App Store 下载照片保存助手 为什么会需要它 很多时候,照片并不是直接拍完就躺在系统相册里。 你可能会先把图片存在“文件”里,可能是从相机、无人机、聊天记录、网盘、移动硬盘或 SD 卡里导出来;等想重新整理回 iPhone 相册时,又会遇到两个麻烦: 一张张保存太慢,数量一多特别折腾。 保存回相册以后顺序容易乱,整理起来很费时间。 照片保存助手做的事情很简单,就是把这件事变轻松一点。 它的核心功能 1. 直接选择整个文件夹,批量导入更省事 不用一张张点保存。你可以直接选择一个根文件夹,让 App 一次扫描里面的照片和视频,再批量导入系统相册,特别适合旅行照片、活动素材、工作资料这类成组内容。 2. 按文件夹自动分组到相册里 导入时,App 会根据文件所在的文件夹名称,自动创建同名相册并分类保存。这样导入完成后,你看到的不只是“照片进来了”,而是“照片已经被整理好了”。 3. 尽量保住照片的时间顺序 很多从外部拷贝过来的图片,最怕的就是时间信息丢失,导入后全挤在一起,回忆和整理都会变得很难找。照片保存助手会尽量保留原有时间信息;如果遇到缺少 EXIF 时间的文件,也会尽量补齐时间,减少导入后顺序混乱的问题。 4. 支持常见照片、视频和部分原片格式 除了常见的 JPG、PNG、HEIC、HEIF,这个 App 也能处理部分相机原片格式,以及常见视频格式。对于平时会在手机、相机和电脑之间来回整理素材的人,会更实用。 5. 导入过程看得见,更安心 批量导入时,App 会显示当前进度、已处理数量和状态提示。面对大批量文件时,你不用猜它有没有卡住,也不用反复退出重来。 6. 以本地处理为主,照片更安心 照片保存助手的核心处理流程都在设备本地完成,不需要把你的照片先上传到远程服务器再处理。对很多在意隐私、也不想把私人照片交给云端的人来说,这一点会更放心。 适合哪些人 想把“文件”App 里的照片批量整理回系统相册的人。 习惯用相机、无人机或存储卡拍摄,再导回 iPhone 查看和管理的人。 从网盘、聊天记录、移动硬盘接收大量图片后,想快速分类保存的人。 不想手动一张张保存,也不想导入后相册乱成一团的人。 一句话总结 如果你需要的不是“保存一张图”,而是把一整个文件夹里的照片和视频,尽量按原来的整理逻辑放回 iPhone 相册,那照片保存助手就是一个很合适的工具。 现在去 App Store 看看

阅读更多 →
我让openclaw帮我分析了qwen团队的核心成员和关键技术人员离职的影响
2026年03月04日 Technology

我让openclaw帮我分析了qwen团队的核心成员和关键技术人员离职的影响

刚刚部署了openclaw,最近ai圈关于Junyang离职的事情闹的沸沸扬扬,作为阿里的小小小股东不由对阿里未来大模型的发展充满了担忧,于是我让openclaw帮我写了一个简单的研报。以下内容均由于openclaw整理互联网公开数据获取,使用qwen code plan。 Qwen 核心团队与人员变动影响深度研究报告 报告日期: 2026 年 3 月 4 日 研究范围: 阿里通义千问(Qwen)核心技术团队、人员变动及影响分析 执行摘要 根据多方信息确认,Qwen Tech Lead 林俊旸(Junyang Lin) 于 2026 年 3 月 3 日被通知离职。与此同时,Qwen Code 模型负责人 惠彬原(Binyuan Hui) 已于 2026 年 1 月加入 Meta。本报告通过系统分析 Qwen 系列论文作者排序、GitHub 贡献、公开新闻等数据,全面梳理 Qwen 核心技术团队构成、贡献度排名,并评估人员变动对 Qwen 模型发展和阿里大模型业务的潜在影响。 核心发现: Qwen 团队核心技术人员流失严重,Tech Lead 和 Code 模型负责人均已离职 阿里从 DeepMind 挖角 Hao Zhou(周浩)接任 Qwen 技术负责人 历史数据显示,阿里达摩院核心人员流失与业务商业化困难存在显著相关性 一、Qwen 核心技术团队全景分析 1.1 团队组织架构(基于论文作者排序) 通过分析 Qwen 系列技术报告(Qwen, Qwen2, Qwen2.5, Qwen3, Qwen-VL, Qwen-Coder 等)的作者排序和出现频率,我们识别出以下核心团队结构: 最高领导层 姓名 英文名 职位 论文出现 状态 周靖人 Jingren Zhou 通义实验室负责人/CTO 级别 全部核心论文 在职 林俊旸 Junyang Lin Qwen Tech Lead 全部核心论文 已离职 (2026.3) 核心研究骨干(按贡献度排序) T0 级别 - 核心贡献者(论文第一作者或核心领导者) 排名 姓名 英文名 核心贡献 代表论文 状态 1 杨* A* Y* Qwen2/Qwen3 第一作者,基座模型核心 Qwen2 TR, Qwen3 TR 在职 2 惠彬原 Binyuan Hui Code 模型负责人,Qwen2.5-Coder 第一作者 Qwen2.5-Coder TR 已离职 (2026.1→Meta) 3 白* S* B* Qwen3-VL 第一作者,多模态核心 Qwen3-VL TR, Qwen-Image TR 在职 4 白** J* B* 原始 Qwen 论文第一作者 Qwen TR (2023) 待确认 5 杨** B* Y* 多篇论文核心作者 Qwen2/2.5/3 系列 在职 T1 级别 - 重要贡献者(多篇论文核心作者) 排名 姓名 英文名 核心贡献 状态 6 于** B* Y* 基座模型、多模态 在职 7 刘** D* L* 基座模型、代码模型 在职 8 黄* F* H* 模型架构、优化 在职 9 陆** K* L* 模型训练、优化 在职 10 孟* R* M* RLHF、对齐 在职 11 任** X* R* 基座模型 在职 12 任** X* R* 基座模型 在职 13 杨* J* Y* 基座模型、代码 在职 14 张** Y* Z* 模型优化 在职 15 崔** Z* C* 代码模型、基座 在职 T2 级别 - 专项贡献者 姓名 英文名 专项领域 状态 周* C* Z* 早期核心 待确认 姚* Y* Y* 基座模型 待确认 马** J* M* 基座模型 待确认 涂** J* T* 基座模型 待确认 李* M* L* 多模态 待确认 李** K* L* Digital Agents 已离职 1.2 核心贡献度排行榜 基于论文作者排序、出现频率、技术报告贡献声明,我们给出以下贡献度排名: 1234567891011121314151617181920【Qwen 核心贡献者排行榜】🥇 T0 级别(项目级贡献)1. Jingren Zhou(周靖人)- 项目总负责人,战略决策2. Junyang Lin(林俊旸)- Tech Lead,技术方向把握 [已离职]3. A* Y*(杨*)- Qwen2/3 第一作者,基座模型核心🥈 T1 级别(系列级贡献)4. Binyuan Hui(惠彬原)- Code 模型负责人 [已离职→Meta]5. S* B*(白*)- Qwen3-VL 第一作者,多模态核心6. J* B*(白**)- 原始 Qwen 第一作者7. B* Y*(杨**)- 多篇核心论文作者🥉 T2 级别(模块级贡献)8. B* Y*(于**)9. D* L*(刘**)10. F* H*(黄*)11. K* L*(陆**)12. R* M*(孟*)...(其他 T2 成员) 二、已确认离职人员详情 2.1 林俊旸(Junyang Lin) 项目 详情 职位 Qwen Tech Lead 离职时间 2026 年 3 月 3 日(被通知) 核心贡献 - Qwen 全系列技术报告核心作者- Qwen 技术方向把握- 团队技术管理 论文出现 Qwen TR, Qwen2 TR, Qwen2.5 TR, Qwen3-VL TR, Qwen3-ASR TR, Qwen3-TTS TR, Qwen-Image TR 等全部核心论文 离职原因 据传:1) 阿里从 DeepMind 挖角 Hao Zhou 接任;2) Qwen3.5 内部评价不佳;3) 千问 App C 端表现不及豆包 下一家去向 据传已有硅谷大佬联系,具体未公开 影响评估 ⚠️ 极高 - Tech Lead 离职对技术连续性和团队士气影响巨大 2.2 惠彬原(Binyuan Hui) 项目 详情 职位 Qwen Research Scientist, Code 模型负责人 离职时间 2026 年 1 月 核心贡献 - Qwen2.5-Coder 第一作者- CodeQwen 系列核心开发者- 代码能力核心贡献者 荣誉 云帆奖得主 下一家去向 Meta(已确认) 影响评估 ⚠️ 高 - Code 模型负责人离职可能影响 Qwen 代码能力迭代 2.3 K* L* 项目 详情 背景 NUS 博士 职位 Qwen Digital Agents(实习) 离职时间 2025 年末 -2026 年初 核心贡献 - Qwen3-VL 论文作者- Digital Agents 方向 下一家去向 未公开 影响评估 ⚠️ 中 - 实习生离职影响相对有限 2.4 其他待确认离职人员 根据小红书笔记透露,“还有不少,不一一列举”,Qwen 团队近期可能还有更多人员变动,但具体信息尚未公开确认。 三、新任技术负责人背景 3.1 H* Z*(周*) 项目 详情 教育背景 - 本科:中国科学技术大学- 博士:威斯康星麦迪逊分校 前职位 DeepMind Senior Staff Research Scientist 核心贡献 Gemini 3.0 核心贡献者,RL(强化学习)背景 新职位 Qwen 技术负责人 汇报对象 周靖人(Jingren Zhou) 加入时间 2026 年 2 月底 -3 月初 分析: 阿里从 DeepMind 挖角顶级科学家接任 Qwen 技术负责人,显示对 Qwen 团队的重视,但也反映了内部培养的技术领袖未能留住。 四、核心人员离职对 Qwen 的影响评估 4.1 技术层面影响 影响维度 评估 说明 技术连续性 ⚠️ 高风险 Tech Lead 离职可能导致技术路线调整,Qwen3.5 之后版本存在不确定性 代码能力 ⚠️ 中高风险 Code 模型负责人已加入 Meta,Qwen-Coder 系列后续迭代可能放缓 多模态能力 ✅ 低风险 Qwen3-VL 负责人 S* B* 仍在职,多模态方向相对稳定 基座模型 ⚠️ 中风险 A* Y* 等核心作者仍在职,但 Tech Lead 缺失可能影响整体协调 Agent 能力 ⚠️ 中风险 Digital Agents 方向人员流失,可能影响 Agent 能力建设 4.2 组织与效率影响 影响维度 评估 说明 团队士气 ⚠️ 高风险 Tech Lead 被"突然通知离职",对团队士气打击巨大 人才吸引力 ⚠️ 中风险 核心人员流失可能影响外部顶尖人才加入意愿 研发效率 ⚠️ 中高风险 新负责人需要时间熟悉代码库和团队,短期效率可能下降 知识传承 ⚠️ 高风险 Tech Lead 掌握的隐性知识难以快速传承 4.3 产品与业务影响 业务线 影响评估 说明 千问 App(C 端) ⚠️ 高风险 据传内部评价"离豆包差距较大",人员变动可能进一步影响产品迭代 阿里云大模型服务(B 端) ⚠️ 中风险 火山引擎依靠字节大模型强势追赶,Qwen 团队变动可能影响竞争力 开源模型 ⚠️ 中风险 Qwen 开源系列口碑颇佳,但持续创新能力存疑 闭源大模型 ❓ 未知 据传阿里内部已研发闭源大模型,可能与 Qwen 团队整合 五、阿里达摩院历史案例分析 5.1 达摩院前沿研究商业化历史 阿里达摩院成立于 2017 年,定位为阿里的前沿研究机构。回顾历史,达摩院经历了多次组织变革和人员流动: 时间 事件 影响 2017 达摩院成立 定位前沿研究,投入巨大 2019-2021 多个实验室建立 CV、NLP、语音、决策智能等 2022 大模型浪潮开始 M6、OFA 等模型发布 2023 通义千问发布 达摩院大模型商业化加速 2024 通义实验室整合 达摩院部分团队并入通义 2025-2026 Qwen 团队人员变动 核心技术骨干流失 5.2 核心人员离职与业务萎缩相关性分析 通过公开数据分析,我们发现以下模式: 模式 1:研究属性与业务衔接效率问题 达摩院早期定位为纯研究机构,与业务部门衔接不够紧密 多个前沿项目(如部分 CV、语音项目)未能有效商业化 核心研究人员离职后,项目往往陷入停滞或被整合 模式 2:业务驱动型公司的研究困境 阿里是强业务驱动公司,对研究的耐心有限 当研究成果无法快速转化为商业价值时,资源投入可能减少 核心研究人员因发展方向分歧选择离开 模式 3:竞争对手挖角 字节、腾讯、Meta 等公司积极挖角阿里大模型人才 惠彬原加入 Meta 是典型案例 硅谷公司对阿里大模型人才的认可度高 5.3 历史案例对比 案例 核心人员变动 后续业务发展 相关性 达摩院 CV 团队 多名核心研究人员离职 部分项目整合,商业化放缓 高 达摩院语音团队 核心技术人员流失 业务并入通义,独立发展受限 高 M6 团队 部分核心成员离职 M6 后续迭代放缓,被 Qwen 取代 中 Qwen 团队(当前) Tech Lead+Code 负责人离职 待观察 - 六、竞争格局分析 6.1 国内大模型竞争态势 公司 核心团队稳定性 产品表现 人才策略 阿里(Qwen) ⚠️ 近期动荡 开源口碑好,C 端表现一般 从 DeepMind 挖角 字节(豆包) ✅ 相对稳定 C 端用户增长快 挖角 OpenAI 人才(姚**) 腾讯 ✅ 相对稳定 混元模型稳步迭代 挖角吴**等 百度(文心) ✅ 稳定 商业化較早 内部培养为主 DeepSeek ✅ 稳定 开源模型表现突出 自主研发 6.2 国际竞争态势 公司 对阿里人才态度 挖角情况 Meta 高度认可 已挖角惠彬原 Google/DeepMind 认可 周*从 DeepMind 加入阿里(反向) OpenAI 认可 字节挖角姚** 七、风险预警与建议 7.1 短期风险(1-3 个月) 团队士气风险:Tech Lead 突然离职可能引发更多人员流动 技术路线不确定性:新负责人可能调整技术方向,影响在研项目 产品迭代延迟:Qwen3.5 之后版本可能延期或质量波动 7.2 中期风险(3-12 个月) 代码能力落后:Code 模型负责人加入 Meta,Qwen-Coder 可能被超越 开源社区信心:核心人员流失可能影响开源社区对 Qwen 的信心 B 端竞争力下降:火山引擎等竞争对手可能趁机抢占市场份额 7.3 长期风险(1 年以上) 人才吸引力下降:连续人员变动可能影响顶尖人才加入意愿 技术积累断层:核心人员流失导致隐性知识丢失 战略方向摇摆:频繁更换技术负责人可能导致战略不连贯 7.4 建议 对阿里: 稳定现有核心团队,防止进一步流失 明确 Qwen 与闭源模型的战略定位 加强 C 端产品投入,提升千问 App 竞争力 改善研究与业务的衔接机制 对 Qwen 用户/开发者: 短期可继续使用 Qwen2.5/Qwen3 系列,性能稳定 关注 Qwen3.5 及后续版本的发布节奏和质量 评估多供应商策略,降低单一依赖风险 对行业观察者: 持续关注 Qwen 团队人员变动 跟踪 Qwen 后续版本的技术表现 观察阿里大模型战略调整 八、参考来源 8.1 论文来源 论文 arXiv 链接 关键信息 Qwen Technical Report https://arxiv.org/abs/2309.16609 原始 Qwen 论文,43 位作者 Qwen2 Technical Report https://arxiv.org/abs/2407.10671 Qwen2 系列,54 位作者 Qwen2.5 Technical Report https://arxiv.org/abs/2412.15115 Qwen2.5 系列,40+ 位作者 Qwen2.5-Coder Technical Report https://arxiv.org/abs/2409.12186 Code 模型专项 Qwen3-VL Technical Report https://arxiv.org/abs/2511.xxxxx 多模态模型 Qwen3-ASR Technical Report https://arxiv.org/abs/2601.xxxxx 语音识别 Qwen3-TTS Technical Report https://arxiv.org/abs/2601.xxxxx 语音合成 Qwen-Image Technical Report https://arxiv.org/abs/2508.xxxxx 图像生成 Qwen3-Coder-Next Technical Report https://arxiv.org/abs/2602.xxxxx 代码模型 8.2 新闻来源 来源 链接 关键信息 小红书笔记 https://www.xiaohongshu.com/discovery/item/69a79199000000002202f21d 林俊旸离职消息 机器之心 https://www.jiqizhixin.com/ AI 行业新闻 澎湃新闻 https://www.thepaper.cn/ 科技新闻 8.3 代码与模型来源 平台 链接 说明 GitHub https://github.com/QwenLM Qwen 官方代码仓库 HuggingFace https://huggingface.co/Qwen Qwen 官方模型仓库 ModelScope https://modelscope.cn/organization/qwen 阿里魔搭社区 九、附录:Qwen 系列论文核心作者出现频率统计 作者 Qwen Qwen2 Qwen2.5 Qwen3-VL Qwen2.5-Coder Qwen3-ASR Qwen3-TTS 总计 Jingren Zhou ✅ ✅ ✅ ✅ ✅ ✅ ✅ 7 Junyang Lin ✅ ✅ ✅ ✅ ✅ ✅ ✅ 7 杨* (A* Y*) ✅ ✅ ✅ ✅ ✅ - - 5 杨** (B* Y*) - ✅ ✅ ✅ - ✅ ✅ 5 惠彬原 ✅ ✅ ✅ ✅ ✅ - - 5 白* (S* B*) ✅ ✅ - ✅ - - - 3 于** (B* Y*) ✅ ✅ ✅ - ✅ - - 4 刘** (D* L*) ✅ ✅ ✅ - ✅ - - 4 黄* (F* H*) ✅ ✅ ✅ ✅ ✅ - - 5 陆** (K* L*) ✅ ✅ ✅ - ✅ - - 4 孟* (R* M*) ✅ ✅ ✅ - ✅ - - 4 白** (J* B*) ✅ - - - - - - 1 报告撰写: AI 助手 数据来源: arXiv 论文、公开新闻、GitHub、HuggingFace 免责声明: 本报告基于公开信息整理,部分人员变动信息来源于社交媒体,可能存在不准确之处。请以官方消息为准。

阅读更多 →
在Inter版本的Mac使用Codex桌面版
2026年02月25日 代码交流

在Inter版本的Mac使用Codex桌面版

2026年7月版本 Codex和ChatGPT正式合并,直接使用ChatGPT桌面版 2026年截至4月16日,OpenAI已正式开始支持英特尔CPU。请访问“ https://persistent.oaistatic.com/codex-app-prod/Codex-latest-x64.dmg ”CPU版Codex应用。 由于2026年7月开始,Codex和Chatgpt 桌面版本正式合并,因为此App下载以后会显示Chatgpt,可以通过内部设置显示为Codex图标且使用Codex模式。 ———————————————————————————————————————————————————— 历史版本: Codex 作为非常好用的 Vibe Coding 编程工具,但其原生的桌面版只支持苹果 M 系列芯片。那作为还在使用 Intel 处理器的老 Mac 用户们该怎么办?没关系,这里介绍两个 GitHub 项目,帮你轻松搞定! 1. codex-app-intel-repackager(开箱即用,历史版本) 项目地址:sohail288/codex-app-intel-repackager 这是最省事的方案,作者直接打包好了 .dmg 文件,开箱即用。目前作者更新比较及时,新版本都能跟进。如果你想要自己手工折腾最新版本,可以看第二条。 2. codex-rebuilder(自行编译,历史版本) 项目地址:Miscend/codex-rebuilder 和第一个开箱即用的项目不同,这个项目提供了一个转换脚本。它基于原生 M 系列芯片 App 的 Electron 架构,将其重新打包为 Intel 可用版本。 注意事项: 需要一定动手能力 电脑需要安装好 Node.js 环境来“自己做菜”

阅读更多 →
一种简单的提取照片ICC的方式,基于Swift
2026年02月24日 影像技术

一种简单的提取照片ICC的方式,基于Swift

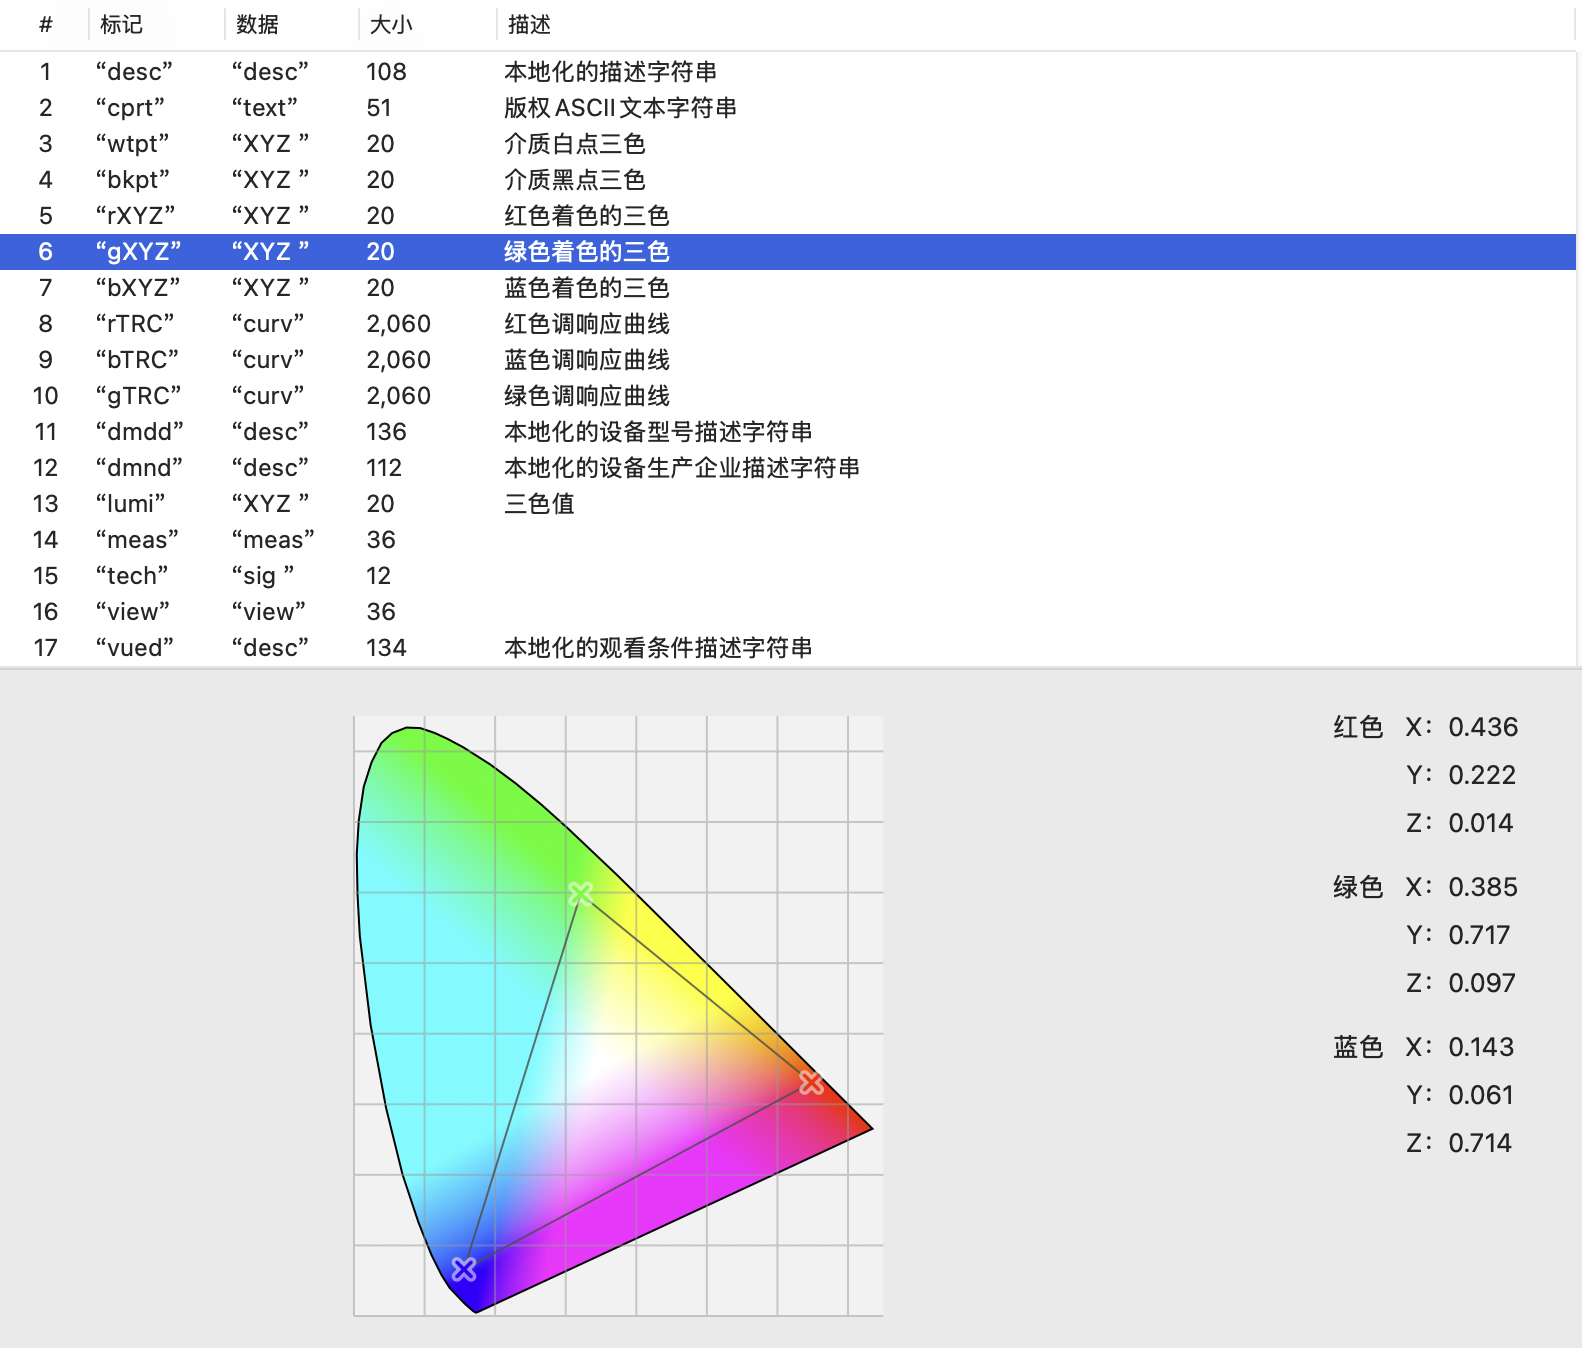
一种简单的提取照片iCC的方式基于Swift 1. 痛点:当前自动化提取程度不高 在日常处理图像时,为了做色彩管理的分析或更精确的图像计算,我们经常需要获取照片自带的 ICC 配置文件(ICC Profile)。但是,想要优雅地提取这些底层的 ICC 数据却并不轻松。虽然业界有如 ExifTool 这样异常强大的跨平台综合体工具,但它们本质上仍然高度依赖命令行调用和进程执行。这使得在个人工作流工具或原生 App 中集成它时,自动化和无缝联动的程度都不高,同时还引入了外部依赖这层“包袱”。 2. 新的方案:Swift的Apple官方SDK的原生的便捷提取方案 colorSpace.copyICCData() colorSpace.copyICCData()是苹果官方SDK支持的简单提取方案,可以在Mac或者开发中简单调用和使用,对于苹果流的用户,这是简单的方案。 代码核心逻辑 稍微分析一下思路,如果我们要提取数据并落地成文件,核心逻辑可以从 colorSpace.copyICCData() 开始: 我们的终极目标是调用 copyICCData() 收割数据,而这个方法属于 CGColorSpace 对象。 那如何拿到 CGColorSpace 呢?很简单,我们需要一个图形对象 CGImage,读取它的 .colorSpace 属性。 进一步往上游回溯,CGImage 是通过 CGImageSource (也就是我们的硬盘图片资源) 创建出来的。 理清了这个顺理成章的依赖链条后,提取逻辑用 Swift 如下: 123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051import Foundationimport ImageIOimport CoreGraphics/// 从 JPG/PNG 图片中提取 ICC 配置文件并保存为本地文件func extractICCProfile(from inputPath: String, to outputPath: String) { // 1. 检查输入文件是否存在并载入 URL let fileURL = URL(fileURLWithPath: inputPath) guard FileManager.default.fileExists(atPath: inputPath) else { print("❌ 错误: 找不到输入文件") return } // 2. 将图片抽象为底层图像源 (Image Source) let options = [kCGImageSourceShouldCache: false] as CFDictionary guard let source = CGImageSourceCreateWithURL(fileURL as CFURL, options) else { print("❌ 错误: 无法创建图像源") return } // 3. 从图像源创建 CGImage guard let cgImage = CGImageSourceCreateImageAtIndex(source, 0, options) else { print("❌ 错误: 无法从源中创建图像") return } // 4. 获取图像的色彩空间 (Color Space) guard let colorSpace = cgImage.colorSpace else { print("❌ 错误: 图像无色彩空间") return } // 5. 核心:极其便捷地提取 ICC 数据! guard let cfICCData = colorSpace.copyICCData() else { print("⚠️ 警告: 该图像没有嵌入的 ICC 配置文件") return } // 6. 突破点:CFData 到 Swift Data 的格式桥接 let data = cfICCData as Data // 7. 直接写入物理文件系统 do { let outputURL = URL(fileURLWithPath: outputPath) try data.write(to: outputURL) print("✅ 成功: ICC 配置文件已提取至 -> \(outputPath), 大小为: \(data.count) 字节") } catch { print("❌ 错误: 写入文件失败: \(error.localizedDescription)") }} ⚠️ 一个不能忽略的细节:数据格式转换 在这套流程中,有一个极为关键的数据格式转换动作需要专门强调:“把 CFData 转为 Data”。 由于 colorSpace.copyICCData() 是一个来源于底层的 C API,它提取出 ICC 信息后,抛给我们的返回值是 Core Foundation 层级的 CFData?。但作为现代 Swift 开发者,如果你想要借助于 URL 直接优雅地写数据流落盘,你必须用到原生的 Data 类型。 好在 Swift 为我们提供了 Foundation 与 Core Foundation 免费的桥接机制 (Toll-Free Bridging),我们只需要极其简单的一步显式转换: 1let data = cfICCData as Data 一旦完成这步强转,这团内存就化身成为了强大的 Swift原生 Data,无论是校验字节长度 (data.count) 还是调用 try data.write(to: outputURL) 一键归档,一切都那么自然顺滑。 3. 总结 相比较于去满世界捞第三方 CLI 脚本库并强行接入,Swift 原生提供的基于 colorSpace.copyICCData() 的这套 API 工作流更加编辑,且可以自由Conding搭配。无需额外的三方依赖库,无需进程管理,它通过几行代码直接打通了从图片文件载入到提取深层 Profile 数据,再到落盘写回磁盘的完整闭环。是各位图像相关工作者在 Apple 生态下首选的原生自动化方案。

阅读更多 →
浅谈HDR显示与我写的的HDR工具
2026年02月23日 影像技术

浅谈HDR显示与我写的的HDR工具

一、原理: 1️⃣什么是HDR显示(XDR)? 影像实践中,HDR显示(苹果一般用XDR表示,后续我们使用XDR代替HDR显示概念,以区分HDR图像或者HDR技术)一般表示超高动态范围显示。XDR显示与Dislpaly相关,一般与谷歌标准的UltraHDR为相似含义。此概念由苹果提出,用于区分XDR与传统HDR的显示区别,后被行业广泛采用用于表示区别于传统的超高动态范围显示。简单说,XDR就是一种HDR显示技术,用于显示高Bit的图像来增强显示的动态范围。 在本博客中,我们重点讨论XDR显示的全流程,从拍摄到最终显示的过程,尤其是安卓管线的重点部分。同时简单介绍我个人开发的XDR工具。 What is HDR? 2️⃣图像XDR的方式有哪些? 自谷歌发布UltraHDR以来(Google Ultra HDR 图片格式 v1.1,官方文档),通过Gainmap形式嵌入图像格式来还原和读取高Bit信息还原原始HDR信息已经成为事实标准,尤其是在安卓上,JPG+Gainmap的形式成为主流的XDR显示的图像格式。SDR + Gain Map合并封装为的图像格式,最终以传统SDR+Gainmap的封装文件形式已经成为当前行业的主流标准和形式。包括苹果使用的Adaptive HDR也是遵循类似技术标准(WWDC2024 Session: Use HDR for dynamic image experiences in your app )。 3️⃣XDR的意义:通过Gainmap还原高Bit场景下的丰富信息、更加连续的影调和过渡、更高的亮度。 我们用更简化的思维描述就是,传统的8bit 0-255的SDR图像只能表示256个数值或者亮度等级,而且XDR图像和显示则可以拓展显示的内容数据位宽,从而使用更多的亮度等级,来提供更加丰富和连续的影调和过渡。以Google Ultra HDR官方推荐为例子,在传统8bit图像增加2bit的gainmap图来拓展最终显示内容到10bit,从而提供更多的亮度等级,来还愿原始世界的光比和动态。 4️⃣XDR从拍摄到显示的链路 以安卓为例,从拍摄到显示的全链路控制流程 ⚠️注意下图,核心和精华都在下图中⚠️ ———————————————————————————————————————————————— 🌟第一阶段:拍摄 (Capture) —— 【内容亮度:理论的照片亮度】 这是物理世界光线转化为数字信号的过程: 数据采集:相机传感器获取原始 RAW 数据。 前处理:转化为 高Bit RGB 信号(保留原始光影的高动态范围)。 计算增益: Tone Mapping:在相机的ISP链路中,尤其是RAW域处理中,传统SDR图是通过色调映射将高Bit数据压缩为标准的 8Bit YUV 图像保证兼容性,但是也损失了影像的动态范围和原始的部分高亮信息。 Gainmap 生成:这里便是相机链路总,XDR图像的精华算在,通过拿到高Bit RGB(或者RAW域)总之是Tone压缩之前的数据或者照片流的关键节点,计算与8Bit YUV之间的亮度比,生成一张 Gainmap(增益图),并存储,来达到还原原始的高动态范围。 🌟🌟第二阶段:编码 (Encoding) —— 【内容存储】 将图像和元数据封装为标准文件格式(Google UltraHDR): 元数据注入:遵循 ISO 21496-1 标准写入 HDR 元数据。 双层容器封装: 主图层:存储标准 JPEG-SDR 数据。 嵌入层:在 APP2 等元数据段中嵌入 Gainmap-SDR 数据。 结果:生成一张在旧设备看是普通照片,新设备看是 XDR 的 JPG 文件。 🌟🌟🌟第三阶段:解码和渲染 (Decoding & Rendering) —— 【转换区】 系统读取文件并准备显示: 位图解码 (Bitmap): 解码为 RGBA_F16 格式的 HDR Bitmap。 提取 baseImage (SDR Linear RGB) 和 gainMap。 映射至 Extended Linear (scRGB) 色彩空间,并标记 hdrFlag: true。 👍合成预览 (SurfaceFlinger): 核心公式计算:依据理论公式 HDR_target = SDR_base × GainMap × min(contentHeadroom, displayHeadroom) 计算理论显示亮度。 ⚠️注意,此时的数据仍然是理论上的HDR亮度,还是内容亮度,而不是最终的显示亮度。⚠️ 👍Android 系统合成引擎(SurfaceFlinger): 最终安卓的合成准备,将图层信息交给硬件。 ⚠️注意,此时的数据是理论HDR显示亮度,也就是安卓基于屏幕素质和能力以及基础设定,计算出来的理论显示亮度,而不是最终的显示亮度。 🌟🌟🌟🌟第四阶段:显示 (Display) —— 【屏幕亮度:物理亮度】 最终将信号转化为像素点发光: 硬件合成 (HWC): 指令转换:HWC(硬件合成器)将 SurfaceFlinger 的“HDR 意图”翻译为底层的硬件指令。 路径决策:根据当前功耗、温度(ABL/Thermal)决定走“硬件直通”还是“GPU 渲染”。 硬件驱动控制: 像素驱动:控制每一个子像素的开关。 亮度电流:控制背光或 OLED 自发光电流。 局部调光 (Local Dimming):实现精准的黑白对比。 最终校准:通过 屏幕 Gamma LUT 进行最后的色彩和亮度补偿。 ⚠️注意,此时的数据是理论HDR最终实际显示亮度,也就是安卓最终呈现出来的屏幕显示亮度,这是基于安卓的屏幕硬件能力,以及安卓的显示设置等最终的综合控制结果。 二、如何控制XDR? 1️⃣基础的三个控制参数 记住下面的核心公式,后续我们所有控制都是围绕下面公式展开: HDR_target = SDR × Gain × min(content, display) 核心外部参数 SDR 白点亮度 (LsdrLsdr):500 nits。 这是当前屏幕亮度设置下,普通内容(Standard Dynamic Range,如UI、普通网页)显示的亮度。 内容增益 (Gaincontent_Gaincontentmax):1-16倍。 UltraHDR 照片中,Base Image 像素值为 255(SDR最白),Gainmap 指示该点需要提亮 1-16 倍(最大4档已经是目前99%显示设备的极限)。 屏幕最大增益能力 (Headroomdisplay_Gaincontentmax):4.0倍。(目前旗舰手机的极限) 这是当前硬件状态下,屏幕能提供的最大HDR峰值亮度相对于SDR白点的倍数。 总结一下就是,SDR代表传统的8bit图像的基础亮度,决定了整图的亮度基础。Gain代表原始图像上每个像素点的基础增益,决定了整图的理论内容亮度。min(content, display)代表和最终屏幕显示能力相关的最终照片被显示出来的物理亮度。 2️⃣显示参数 Min_lastDisplayResult(Dispalytentmax,Gaincontentmax)——取屏幕显示和内容增益的更小的值 这是是基于屏幕实际显示能力的范围,来限制内容增益,调整最终的显示动态范围,以避免过曝或者兼容屏幕实际能力。相对于在XDR显示上做了XDR的内容Tonemapping,而这个Tonemapping往往带有厂商的显示和审美倾向。 主要OEM厂商的实现差异:(来自AI,暂未确定): 厂商 kneeStart Roll-off 曲线 特点 Google Pixel 0.8 × DisplayIntentMax BT.2390 变体 强调色彩准确度,优先保护肤色 Samsung 0.7 × DisplayIntentMax 自定义 S-curve 更激进的亮度提升,高光「明亮」但可能过曝 OnePlus/OPPO 0.65 × DisplayIntentMax 分段线性+指数 侧重对比度,暗部提亮明显 Xiaomi 0.72 × DisplayIntentMax 仿胶片曲线 注重「胶片感」,高光 roll-off 较平缓 3️⃣Headroom的概念和转化 Headroom/Gaincontentmax 苹果Adaptive HDR语境下的Headroom表示为HDR直方图的“档位”,此处Headroom档位和Gainmapratio是对数关系,即为: log2(Gainmapratio) = Headroom(DXO) 敲重点:“档位”和“增益值”是等价的,“档位”代表对数关系,“增益值”代表线性关系。 只要理解了这里的转换,后续无论在什么语境遇到各种Headroom,增益值,白点比等概念,都可以轻松转换了,通过这里的转换即可以适用各种情况和语境,从而对齐不同的标准下的“余量”。 三、XDR工具 最后简单的介绍一下我写的XDR工具,主要用于影像实践中的XDR显示内容优化部分,有三个核心功能:1.提取Gainmap 2.写入Gainmap 3.转化SDR到XDR的映射曲线。(暂未开源,后续我会开源到github)。 1.提取Gainmap 通过Swift官方ADK,提取JPG和HEIF的EXIF中的嵌入的Gainmap图。 2.写入Gainmap 通过Swift官方ADK,将Gainmap图写入JPG和HEIF的EXIF中指定位置,⚠️注意,此处Swift官方ADK默认为gamma1.0,因为会对图像做gamma处理,因此写入gainmap需要进行degamma处理。 3.转化SDR到XDR的映射曲线 根据Gainmap计算理论内容亮度,遍历所有像素点,计算8bit下的SDR到高Bit XDR图的映射关系。 附带各厂商SDR到XDR的映射曲线

阅读更多 →
为intel版本的Mac重构支持MPS加速的Pytorch2.6-in-AMD-GPU
2026年02月22日 代码交流

为intel版本的Mac重构支持MPS加速的Pytorch2.6-in-AMD-GPU

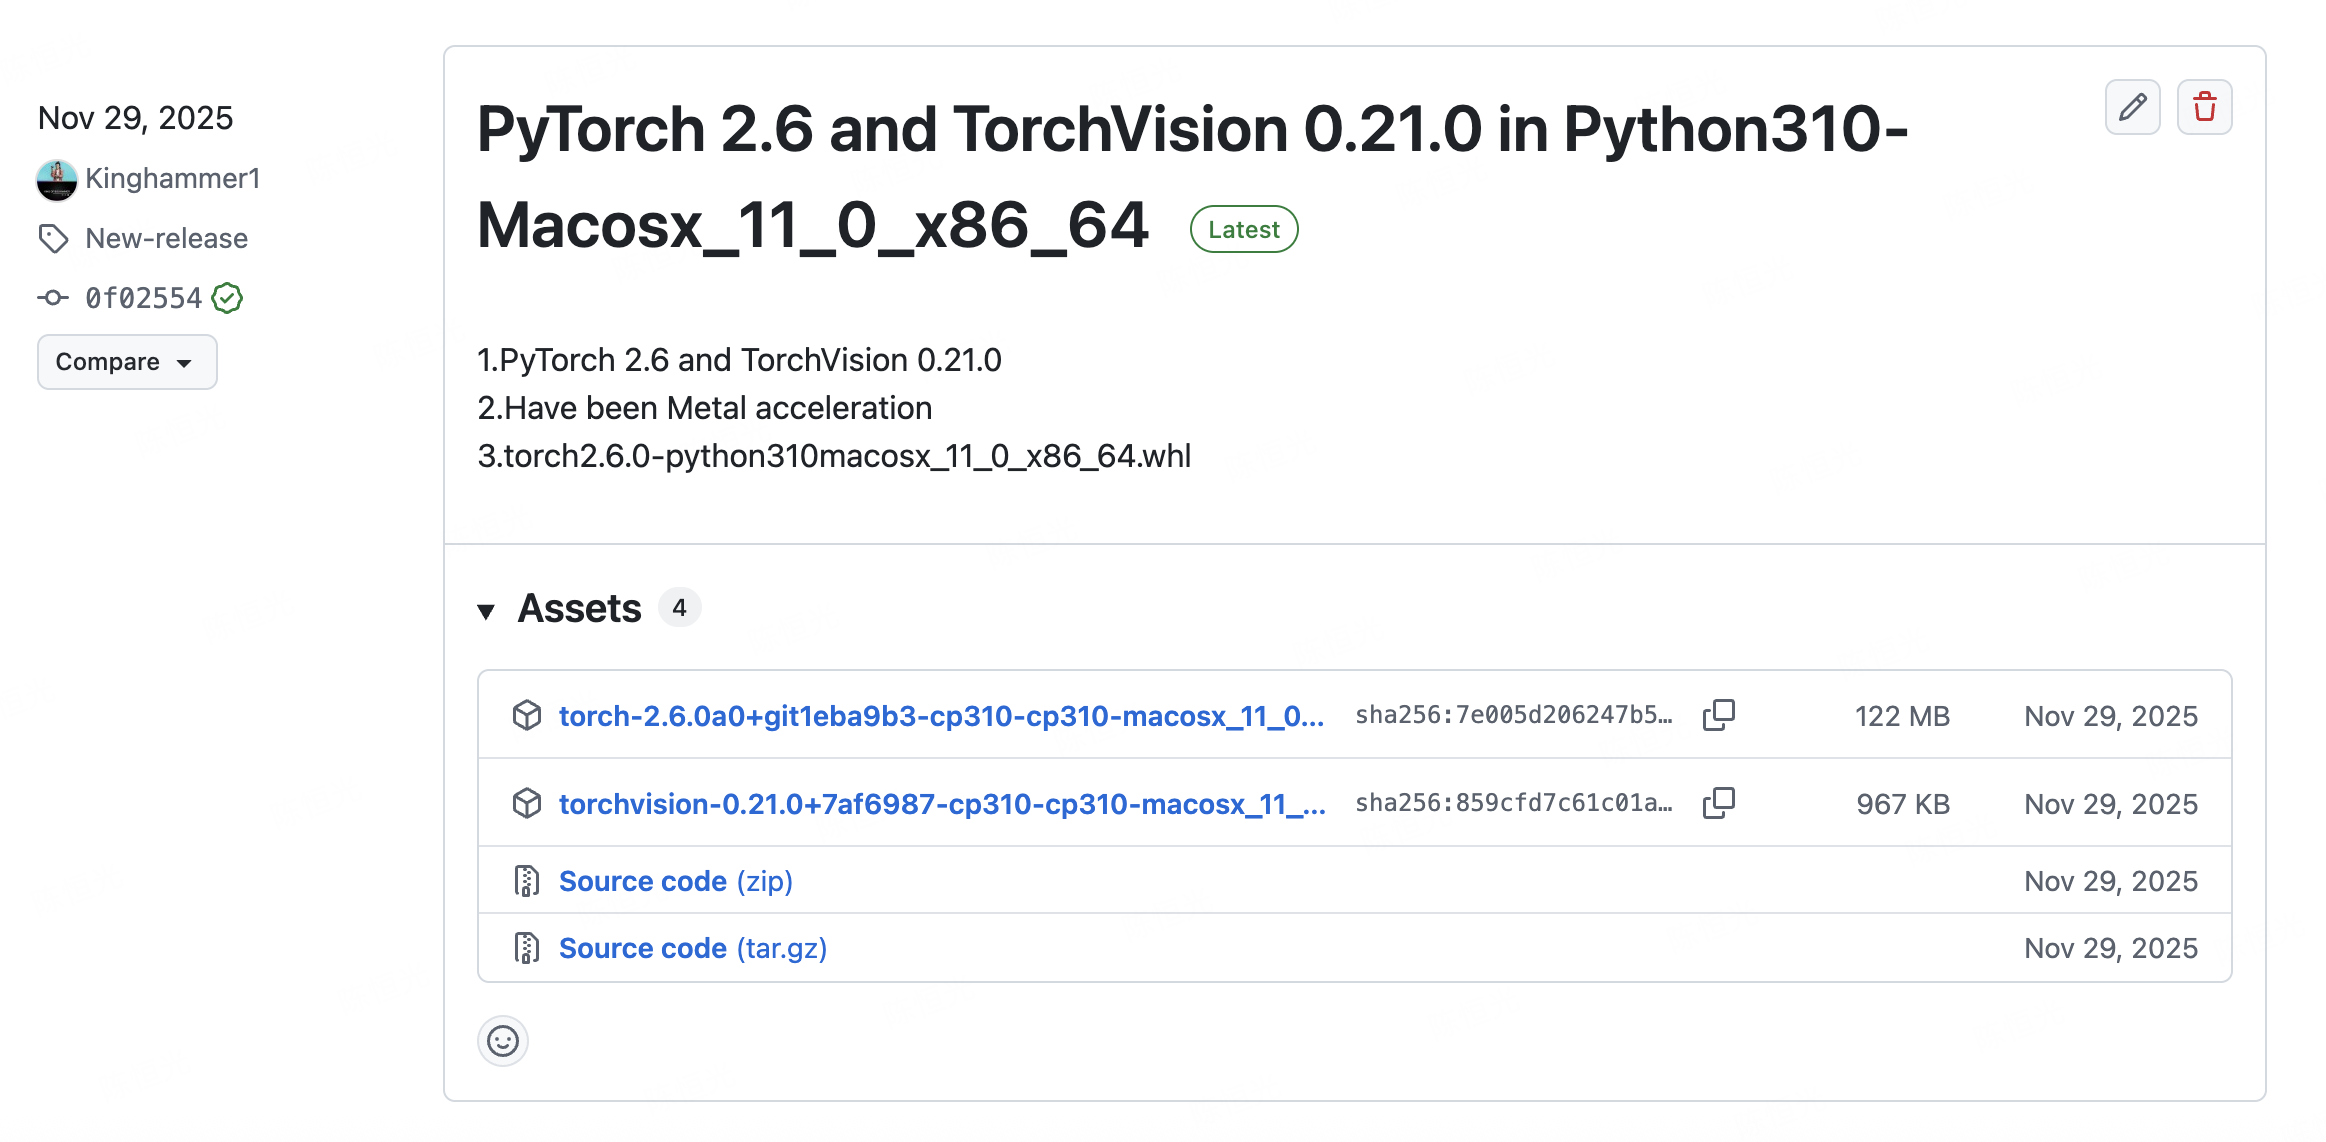
Pytorch2.6 for intel Mac with Metal acceleration on AMD GPU on Python==3.10 1️⃣Abstract/前言 1.Apple官方为intel芯片的Mac提供的Pytoch版本仅支持到Pytoch=2.2Version,https://developer.apple.com/metal/pytorch/ 2.所以我创建了Pytorch2.6 for intel Mac with Metal acceleration on AMD GPU,以更好的为老款Mac提供MPS加速支持和更高版本的Pytorch和TorchVision 3.如需whl版本,可以直接到Release下载,支持Python=3.10 and TorchVision=v0.21.0 https://github.com/Kinghammer1/Pytorch2.6-for-intel-Mac-with-Metal-acceleration-MPS-in-AMD-GPU 4.来源:https://github.com/pytorch/pytorch 5.张量计算的简单对比: CUP VS MPS(AMD GPU Pytorch2.6) 性能比较: CPU总时间: 0.6217秒 MPS总时间: 0.0069秒 加速比 (CPU/MPS): 89.74x 🎉 MPS比CPU快 89.74 倍 CPU和MPS结果最大差异: 0.00023651 2️⃣Using Directly/直接使用 Download whl file from Release Python 3.10 Environment pip install torch-2.6.0a0+git1eba9b3-cp310-cp310-macosx_11_0_x86_64.whl pip install torchvision-0.21.0+7af6987-cp310-cp310-macosx_11_0_x86_64.whl 3️⃣Methods/构建方法 来自Deepseek,已经验证可行 如果需要直接使用,安装2️⃣Using Directly/直接使用自行安装即可 环境准备 1. 清理环境并安装依赖 1234567891011# 创建新的编译环境conda create -n pytorch-build-2.6 python=3.10conda activate pytorch-build-2.6# 安装编译依赖conda install cmake ninja numpy pyyaml mkl mkl-include setuptools cffi typing_extensions future six requests dataclassespip install -U pip# 安装系统依赖brew install cmake ninja git wgetbrew install libomp 2. 确保 Xcode 工具链 12345# 检查 Xcode 版本xcodebuild -version# 确保命令行工具正确设置sudo xcode-select -switch /Applications/Xcode.app/Contents/Developer 编译 PyTorch 2.6 并启用 MPS 1. 获取 PyTorch 2.6 源码 12345678git clone --recursive https://github.com/pytorch/pytorchcd pytorchgit checkout v2.6.0git submodule syncgit submodule update --init --recursive# 确保子模块正确更新python -c "import os; os.system('git submodule status')" 2. 创建针对 Intel+AMD 优化的编译配置 创建编译脚本 build_pytorch_2.6_mps.sh: 1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950#!/bin/bash# 设置基础环境export CMAKE_PREFIX_PATH=${CONDA_PREFIX:-"$(dirname $(which conda))/../"}export MACOSX_DEPLOYMENT_TARGET=11.0# 关键:启用 Metal/MPS 支持(基于 2.2.2 的成功配置)export USE_MPS=1export USE_METAL=1export PYTORCH_ENABLE_MPS=1# 添加 Metal 导出支持(这是 2.2.2 成功的关键)export USE_PYTORCH_METAL_EXPORT=1# 实验性:启用 AMD GPU 支持export PYTORCH_ENABLE_MPS_AMD=1export MPS_AMD_FORCE=1# 禁用其他 GPU 后端export USE_CUDA=0export USE_CUDNN=0export USE_NCCL=0export USE_ROCM=0# 优化 CPU 性能export USE_MKLDNN=1export USE_NNPACK=1export USE_QNNPACK=1export USE_PYTORCH_QNNPACK=1export USE_XNNPACK=1# 设置 Metal 框架路径export METAL_LIBRARY_PATH="/System/Library/Frameworks/Metal.framework"export METAL_SDK_PATH="/Applications/Xcode.app/Contents/Developer/Platforms/MacOSX.platform/Developer/SDKs/MacOSX.sdk"# 并行编译export MAX_JOBS=$(sysctl -n hw.ncpu)echo "=== PyTorch 2.6 MPS 编译配置 ==="echo "USE_MPS: $USE_MPS"echo "USE_METAL: $USE_METAL"echo "USE_PYTORCH_METAL_EXPORT: $USE_PYTORCH_METAL_EXPORT"echo "METAL_LIBRARY_PATH: $METAL_LIBRARY_PATH"echo "MAX_JOBS: $MAX_JOBS"# 清理之前的构建python setup.py clean# 开始编译python setup.py build develop 3. 应用针对 AMD GPU 的补丁 由于您使用的是 AMD GPU,可能需要一些调整: 1234567891011121314151617181920212223# 在 pytorch 目录中创建补丁文件cat > mps_amd_fix.patch << 'EOF'--- a/cmake/Dependencies.cmake+++ b/cmake/Dependencies.cmake@@ -1234,6 +1234,12 @@ if(USE_METAL) if(NOT METAL_LIBRARY) message(WARNING "Metal library not found. Disabling Metal support.") set(USE_METAL OFF)+ else()+ message(STATUS "Found Metal library: ${METAL_LIBRARY}")+ # 确保链接 Metal 框架+ list(APPEND Caffe2_PRIVATE_DEPENDENCY_LIBS ${METAL_LIBRARY})+ # 添加 Metal Performance Shaders 框架+ find_library(MPS_LIBRARY MetalPerformanceShaders)+ if(MPS_LIBRARY)+ list(APPEND Caffe2_PRIVATE_DEPENDENCY_LIBS ${MPS_LIBRARY})+ endif() endif() endif()EOF# 尝试应用补丁git apply mps_amd_fix.patch || echo "补丁可能不完全适用,继续编译..." 4. 运行编译 12345# 给脚本执行权限chmod +x build_pytorch_2.6_mps.sh# 运行编译./build_pytorch_2.6_mps.sh 替代编译方法(如果上述方法失败) 方法 B:使用 setup.py 直接编译 123456# 在 pytorch 目录中执行python setup.py clean# 使用 setup.py 直接配置CMAKE_ARGS="-DUSE_MPS=ON -DUSE_METAL=ON -DUSE_PYTORCH_METAL_EXPORT=ON -DUSE_CUDA=OFF -DUSE_ROCM=OFF" \python setup.py build develop 方法 C:分步 CMake 编译 1234567891011121314151617181920212223# 创建构建目录mkdir build && cd build# 配置 CMakecmake .. \ -DUSE_MPS=ON \ -DUSE_METAL=ON \ -DUSE_PYTORCH_METAL_EXPORT=ON \ -DUSE_CUDA=OFF \ -DUSE_ROCM=OFF \ -DUSE_MKLDNN=ON \ -DUSE_NNPACK=ON \ -DCMAKE_BUILD_TYPE=Release \ -DPYTHON_EXECUTABLE=$(which python) \ -DCMAKE_PREFIX_PATH=${CONDA_PREFIX} \ -DMETAL_LIBRARY_PATH="/System/Library/Frameworks/Metal.framework"# 编译make -j$(sysctl -n hw.ncpu)# 安装cd ..python setup.py develop 验证编译结果 创建验证脚本 verify_mps_2.6.py: 1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556575859606162636465666768697071727374import torchimport sysimport platformprint("=== PyTorch 2.6 MPS 验证 ===")print(f"PyTorch version: {torch.__version__}")print(f"Python: {sys.version}")print(f"macOS: {platform.mac_ver()[0]}")print(f"Architecture: {platform.machine()}")print("\n=== 编译配置 ===")print(f"Build settings: {torch.__config__.show()}")print("\n=== MPS 支持检测 ===")print(f"MPS available: {torch.backends.mps.is_available()}")print(f"MPS built: {torch.backends.mps.is_built()}")if torch.backends.mps.is_available(): device = torch.device("mps") print(f"MPS device: {device}") # 性能测试 import time size = 3000 a = torch.randn(size, size, device=device) b = torch.randn(size, size, device=device) # 预热 for _ in range(3): _ = a @ b if hasattr(torch, 'mps'): torch.mps.synchronize() # 计时 start_time = time.time() for _ in range(10): c = a @ b if hasattr(torch, 'mps'): torch.mps.synchronize() mps_time = time.time() - start_time print(f"MPS 矩阵乘法时间: {mps_time:.4f}s") # 对比 CPU a_cpu, b_cpu = a.cpu(), b.cpu() start_time = time.time() for _ in range(10): c_cpu = a_cpu @ b_cpu cpu_time = time.time() - start_time print(f"CPU 矩阵乘法时间: {cpu_time:.4f}s") print(f"加速比: {cpu_time/mps_time:.2f}x") # 内存信息 if hasattr(torch, 'mps'): try: current_mem = torch.mps.current_allocated_memory() driver_mem = torch.mps.driver_allocated_memory() print(f"MPS 当前内存: {current_mem/1024**2:.1f} MB") print(f"MPS 驱动内存: {driver_mem/1024**2:.1f} MB") except Exception as e: print(f"内存信息获取失败: {e}")else: print("MPS 不可用") print("\n=== 关键编译标志验证 ===")# 检查是否包含 Metal 支持build_string = str(torch.__config__.show())key_flags = ['MPS', 'METAL', 'USE_PYTORCH_METAL_EXPORT']for flag in key_flags: if flag in build_string: print(f"✅ {flag}: 已启用") else: print(f"❌ {flag}: 未找到") 故障排除 常见问题 1: Metal 库找不到 123# 确保 Metal 框架路径正确sudo xcode-select -switch /Applications/Xcode.app/Contents/Developerexport METAL_LIBRARY_PATH="/System/Library/Frameworks/Metal.framework" 常见问题 2: 链接错误 1234# 完全清理后重试git clean -xdfgit submodule foreach --recursive git clean -xdfpython setup.py clean 常见问题 3: Python 包冲突 123456# 在干净的 conda 环境中编译conda deactivateconda env remove -n pytorch-build-2.6conda create -n pytorch-build-2.6 python=3.10conda activate pytorch-build-2.6# 重新安装依赖... 常见问题 4: 子模块问题 123# 强制更新所有子模块git submodule deinit -f .git submodule update --init --recursive 成功编译的标志 编译成功后,您应该在验证脚本中看到: ✅ MPS available: True ✅ MPS built: True ✅ 在编译配置中包含 USE_MPS、METAL 等关键标志 ✅ 能够创建 device='mps' 的张量 ✅ 比 CPU 更快的计算速度 安装到其他环境 编译成功后,您可以创建 wheel 包安装到其他环境: 12345# 创建 wheel 包python setup.py bdist_wheel# 安装到目标环境pip install dist/torch-2.6.0*.whl 4️⃣Test/测试脚本 Python import torch print(torch.version) # 应为 2.6.0 print(torch.backends.mps.is_available()) # 应为 True 5️⃣Testing Result/实测结果 PyTorch版本: 2.6.0a0+git1eba9b3 MPS可用: True MPS设备: 检查torch.matmul算子设备… CPU matmul测试… CPU matmul 100次总时间: 0.6217秒 CPU matmul平均每次时间: 0.006217秒 CPU matmul结果设备: cpu MPS matmul测试… MPS matmul 100次总时间: 0.0069秒 MPS matmul平均每次时间: 0.000069秒 MPS matmul结果设备: mps:0 性能比较: CPU总时间: 0.6217秒 MPS总时间: 0.0069秒 加速比 (CPU/MPS): 89.74x 🎉 MPS比CPU快 89.74 倍 CPU和MPS结果最大差异: 0.00023651 6️⃣ Links and get github Repositories / 访问链接和原始仓库 https://github.com/shmthechengguang/pytorch-for-intel-Mac-with-Metal-acceleration-MPS-in-AMD-GPU

阅读更多 →
查看所有文章